Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA
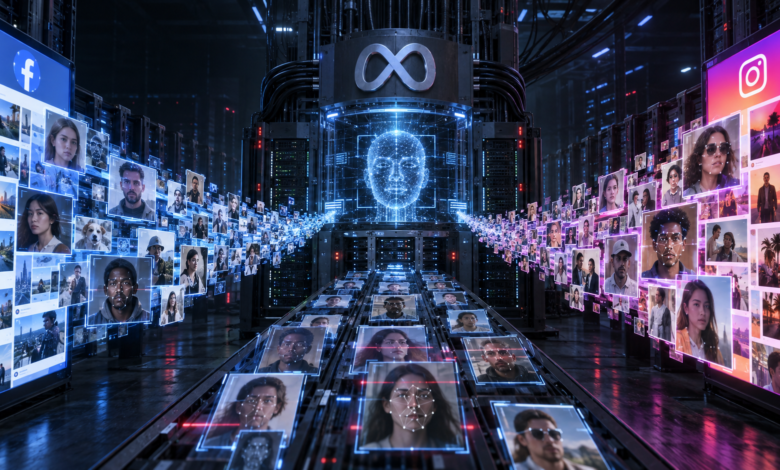
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA. Ação coletiva relaciona imagens publicadas nas redes aos modelos Emu e Muse Image e ao sistema NameTag; empresa nega irregularidades e afirma que o recurso não chegou aos consumidores
Uma fotografia publicada no Instagram ou no Facebook pode ser transformada em dado biométrico para identificar uma pessoa por meio de óculos inteligentes? Essa é a pergunta central de uma ação coletiva apresentada contra a Meta nos Estados Unidos. O processo acusa a controladora das duas redes sociais de extrair informações de rostos presentes em fotos de usuários para treinar sistemas de inteligência artificial e desenvolver recursos de reconhecimento facial. A Meta nega irregularidades, afirma que o caso distorce seu trabalho e ressalta que o sistema NameTag não foi disponibilizado aos consumidores.
A disputa está apenas no início. Não existe, até o momento, decisão judicial que confirme que a Meta usou as imagens dos autores da ação para criar identificadores biométricos. Também não foi demonstrado publicamente quais fotografias, se alguma, alimentaram a base associada ao NameTag. Essa distinção é essencial para compreender o caso com precisão. A existência do processo, do código ligado ao recurso e das políticas da Meta sobre o uso de conteúdo público em inteligência artificial está documentada. Já a ligação específica entre as fotos dos autores e os sistemas citados continua sendo uma alegação que deverá ser testada durante a produção de provas.
Protocolada em 4 de setembro de 2026 no Tribunal Distrital dos Estados Unidos para o Norte de Illinois, a ação recebeu o número 1:26-cv-10773. Os autores são Francisco Alvarez e seu filho, residentes de Illinois, além de Jeremy Wahl e sua filha de 10 anos, residentes da Califórnia. Eles pedem que o caso seja reconhecido como ação coletiva em nome de grupos que podem incluir pessoas cujas imagens foram publicadas no Facebook, no Instagram ou enviadas a ferramentas de inteligência artificial generativa da Meta desde 4 de setembro de 2021.
O processo reúne dois debates relacionados, mas juridicamente distintos. O primeiro envolve o possível uso de fotografias para criar assinaturas numéricas de rostos capazes de reconhecer pessoas. O segundo diz respeito ao treinamento e à operação de modelos de geração de imagens, entre eles Emu e Muse Image. A petição sustenta que as duas práticas poderiam resultar na coleta ou no armazenamento de informações biométricas sem aviso adequado e sem consentimento. A Meta contesta essa interpretação.
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA. O que a ação coletiva alega contra a Meta
De acordo com a petição inicial apresentada no tribunal federal de Illinois, a Meta teria obtido fotos de usuários e de outras pessoas retratadas em publicações para desenvolver tecnologias de reconhecimento facial e inteligência artificial generativa. Os autores afirmam que imagens comuns foram processadas de forma a produzir representações numéricas dos rostos, conhecidas em inglês como faceprints, embeddings, vetores faciais ou codificações faciais.
Esses termos descrevem arquivos matemáticos que representam características de uma face. Em vez de guardar apenas a fotografia como uma coleção de pixels, um sistema pode medir relações entre olhos, nariz, boca, contornos e outros elementos. O resultado é uma sequência de números usada para comparar uma imagem com outra. Quando essa representação permite identificar uma pessoa, ela pode se enquadrar em definições legais de identificador biométrico ou informação biométrica, dependendo da legislação aplicável e da maneira como o sistema funciona.
A petição afirma que esse processamento teria ocorrido no desenvolvimento do NameTag e no treinamento ou uso de modelos como Emu e Muse Image. Para os autores, a Meta deveria ter informado claramente o objetivo da coleta, estabelecido regras públicas de retenção e obtido autorização antes de produzir ou manter dados biométricos. Essas afirmações ainda precisam ser comprovadas.
O próprio documento reconhece um limite decisivo para a acusação. A empresa não informou quais imagens, se alguma, foram usadas para gerar os identificadores faciais questionados. Os advogados argumentam que os registros necessários estão sob controle da Meta e deverão ser obtidos na fase de produção de provas, quando as partes podem solicitar documentos, bancos de dados, depoimentos técnicos e informações sobre o funcionamento dos sistemas.
Esse ponto impede uma conclusão prematura. O fato de uma empresa ter acesso a grandes quantidades de fotografias não prova, por si só, que uma imagem específica foi convertida em dado biométrico. Da mesma forma, a presença de uma foto em um conjunto de treinamento não significa automaticamente que o modelo armazenou uma cópia identificável daquela pessoa. O tribunal deverá examinar o desenho técnico de cada sistema, os dados efetivamente utilizados, as políticas de retenção e o grau de controle exercido pela Meta.
O que é o NameTag e por que ele está no centro do processo
O NameTag é descrito como um sistema de reconhecimento facial explorado para os óculos inteligentes da Meta e para o aplicativo que acompanha esses dispositivos. Uma investigação da WIRED informou que componentes do recurso foram encontrados dentro do aplicativo Meta AI, instalado em milhões de telefones. Segundo a análise, o sistema poderia converter rostos capturados pelos óculos em assinaturas biométricas e compará-las com identificadores guardados no celular do usuário. A função não estava ativada para consumidores.
A reportagem que revelou a ação coletiva explica que a base local do telefone estava configurada para receber atualizações da Meta, mas a origem dos identificadores subjacentes não pôde ser determinada. A petição sugere que eles poderiam ter sido produzidos a partir de fotos do Facebook e do Instagram. Para sustentar essa hipótese, cita declarações sobre a possibilidade de reconhecer conexões do usuário ou pessoas com perfis públicos e menciona uma patente da empresa relacionada à comparação de rostos com fotos de perfil e outras imagens.
Há uma diferença importante entre um sistema construído para reconhecer rostos e um recurso efetivamente lançado ao público. A descoberta de código tecnicamente funcional pode demonstrar que houve desenvolvimento e testes, mas não estabelece, sozinha, que consumidores tiveram acesso ao recurso nem que ele foi usado para identificar pessoas no cotidiano. A Meta afirma que nada foi lançado e que nenhuma decisão final foi tomada sobre o futuro do NameTag.
A empresa também declara que não está construindo um banco universal de rostos. Essa resposta enfrenta apenas uma parte da controvérsia. Mesmo sem uma base central capaz de identificar qualquer pessoa, ainda pode existir discussão jurídica sobre bancos locais guardados em telefones, atualizações enviadas por servidores e a capacidade de a empresa controlar ou acessar os dados.
A localização técnica dos identificadores pode influenciar a análise, mas não resolve automaticamente a questão. A WIRED relatou que decisões anteriores sobre sistemas armazenados no próprio aparelho chegaram a resultados diferentes. Em alguns casos, tribunais consideraram relevante a possibilidade de uma empresa exercer controle sobre dados mantidos no dispositivo. Em outros, ações foram rejeitadas porque a companhia não recebia nem acessava as representações faciais. Por isso, o processo contra a Meta deverá esclarecer quem gera o identificador, onde ele fica, quem pode consultá-lo, como recebe atualizações e por quanto tempo permanece armazenado.
Treinamento de IA não é a mesma coisa que reconhecimento facial
O processo também contesta o uso de fotos em modelos generativos, mas essa parte exige uma distinção técnica. Um sistema de reconhecimento facial é projetado para comparar um rosto com uma referência e determinar identidade ou similaridade. Um gerador de imagens aprende padrões visuais para criar novas figuras a partir de comandos. Embora os dois possam processar rostos, eles têm finalidades e arquiteturas diferentes.
A Meta informa em sua página sobre inteligência artificial generativa que pode usar informações compartilhadas em seus produtos, como publicações, fotos, legendas e interações com recursos de IA, para desenvolver e melhorar modelos. A empresa também declarou publicamente que conteúdo público do Facebook e do Instagram representa uma vantagem de dados para seus sistemas. Isso confirma, em termos gerais, o uso de conteúdo público no desenvolvimento de IA. Não confirma que toda foto disponível tenha sido usada, nem demonstra que cada imagem tenha gerado um identificador biométrico permanente.
A petição adota uma interpretação mais ampla. Segundo os autores, quando um modelo analisa uma face durante treinamento ou uso, ele produz uma representação numérica associada a características do indivíduo. Eles alegam que essa representação pode constituir informação biométrica e ficar incorporada ao sistema. Essa será uma das teses técnicas mais disputadas do processo.
Em aprendizado de máquina, o treinamento modifica um grande conjunto de parâmetros com base em padrões encontrados em muitos exemplos. Esses parâmetros não funcionam necessariamente como uma pasta de fotografias. Ainda assim, modelos podem memorizar determinados elementos, reproduzir semelhanças ou demonstrar capacidades de reconhecimento. A pergunta jurídica não será respondida apenas com a afirmação genérica de que o modelo aprendeu com fotos. Será necessário avaliar se a tecnologia criou ou reteve uma representação ligada a uma pessoa identificável e se essa operação se enquadra nas definições das leis invocadas.
Também será importante separar treinamento de inferência. Treinamento é a etapa em que o modelo aprende com uma coleção de dados. Inferência é o momento em que alguém usa o sistema, por exemplo, ao enviar uma fotografia e pedir uma nova imagem. A ação tenta alcançar as duas situações. Ela inclui pessoas retratadas em conteúdo usado no desenvolvimento dos modelos e pessoas cujas imagens teriam sido enviadas às ferramentas por meio de comandos.
Emu, Muse Image e o uso de imagens públicas
Emu é um modelo de geração de imagens usado pela Meta em recursos capazes de criar figuras a partir de texto. A empresa reconheceu que fotos públicas do Instagram contribuíram para o treinamento do sistema. Para a ação coletiva, esse dado apoia a hipótese de que rostos de usuários também foram processados. Para a defesa, a divulgação sobre o uso de conteúdo público demonstra transparência e não equivale à coleta ilegal de biometria.
Muse Image ampliou o debate ao permitir a criação de imagens baseadas em contas públicas do Instagram. O recurso recebeu críticas porque usuários podiam gerar representações de outras pessoas. A função foi retirada do Instagram poucos dias depois, após a Meta reconhecer que a implementação não havia correspondido às expectativas do público. A petição afirma que capacidade semelhante continuou acessível por outros produtos da companhia, algo que também poderá ser discutido no processo.
O episódio do Muse Image mostra como três categorias podem se sobrepor. Existe a fotografia original publicada por uma pessoa, existe o processamento dessa imagem por um modelo e existe o resultado criado para outro usuário. Cada etapa levanta perguntas próprias sobre privacidade, direito de imagem, consentimento e retenção de dados. Uma resposta válida para o treinamento do modelo pode não resolver o uso comercial da aparência de alguém, assim como uma autorização para hospedar uma foto em uma rede social pode não ser considerada autorização para transformá-la em referência de reconhecimento facial.
O papel da lei biométrica de Illinois
Os autores de Illinois baseiam parte central da ação na Biometric Information Privacy Act, conhecida como BIPA. A lei estabelece requisitos para empresas privadas que coletam ou mantêm determinados dados biométricos. Entre eles estão a divulgação de uma política de retenção, a definição de prazo para destruição das informações e a obtenção de consentimento antes de certas formas de coleta.
A ação invoca as seções 15(a) e 15(b). A primeira trata, entre outros pontos, da política pública de retenção e descarte. A segunda exige informação e autorização por escrito antes que uma entidade privada colete ou obtenha identificadores ou informações biométricas. Os autores pedem medidas para interromper práticas consideradas irregulares, exigir políticas compatíveis com a lei e obter indenizações.
O pedido menciona valores de até US$ 5 mil por violação intencional ou imprudente e US$ 1 mil por violação negligente, ou danos efetivos quando forem maiores. Isso não significa que esses valores serão pagos. Antes de qualquer indenização, o tribunal terá de decidir se os dados contestados se enquadram na BIPA, se a Meta os coletou, se os autores podem representar os grupos propostos, se houve violação e qual regra de cálculo deve ser aplicada.
Uma alteração aprovada em Illinois em 2024 reduziu a exposição potencial das empresas ao limitar, em determinadas situações, a recuperação a uma violação por pessoa, em vez de multiplicar automaticamente o valor por cada leitura ou transmissão. O efeito dessa mudança e sua aplicação aos fatos alegados poderão influenciar a dimensão financeira do caso.
As acusações apresentadas na Califórnia
Para os autores da Califórnia e para o grupo nacional proposto, a petição também apresenta teses baseadas no direito de publicidade, na apropriação comercial e no direito constitucional à privacidade. O artigo 3344 do Código Civil da Califórnia prevê responsabilidade quando o nome, a voz, a assinatura, a fotografia ou a aparência de uma pessoa é usada conscientemente para fins comerciais sem consentimento prévio, observadas as exceções da própria lei.
Nesse ponto, os autores alegam que a aparência das pessoas teria contribuído para produtos comerciais de inteligência artificial e reconhecimento facial. A Meta poderá contestar tanto a existência do uso individual quanto a ligação direta exigida entre uma imagem específica e a exploração comercial. Também poderá argumentar sobre consentimento, termos do serviço, caráter público do conteúdo, funcionamento dos modelos e alcance territorial das normas estaduais.
A presença de duas crianças entre os autores acrescenta atenção ao caso, pois a legislação californiana menciona expressamente a autorização do responsável quando a aparência de um menor é usada nas circunstâncias cobertas pela norma. Ainda assim, a idade dos autores não dispensa a necessidade de demonstrar que suas fotos foram usadas da forma alegada.
O que a Meta responde
Em declaração enviada à WIRED, a Meta classificou o processo como sem fundamento e afirmou que ele apresenta uma descrição incorreta do trabalho da empresa. A companhia sustenta que foi transparente sobre o uso de informações no desenvolvimento e na melhoria de produtos de inteligência artificial.
Sobre o NameTag, a Meta diz que o recurso não foi entregue aos consumidores e que não há decisão final sobre um possível lançamento. Caso decida disponibilizar alguma função, afirma que adotará uma abordagem cuidadosa e transparente. A empresa também rejeita a ideia de que esteja criando um banco universal de rostos.
Essa resposta estabelece as principais linhas da controvérsia. A Meta enfatiza que pesquisar ou testar uma tecnologia não equivale a colocá-la em operação. Os autores, por outro lado, argumentam que a suposta coleta biométrica poderia ter ocorrido durante desenvolvimento, treinamento e testes, antes de qualquer lançamento comercial. Assim, a ausência de acesso público pode ser relevante, mas não encerra a discussão sobre como os dados foram obtidos e processados.
O histórico de disputas biométricas da empresa
O novo processo surge após acordos expressivos envolvendo reconhecimento facial. Em 2020, o Facebook concordou em pagar US$ 650 milhões para encerrar uma ação coletiva em Illinois relacionada ao antigo recurso de sugestões de marcação. Em 2021, a empresa anunciou o encerramento de seu sistema de reconhecimento facial e a exclusão de mais de um bilhão de modelos faciais. Em 2024, a Meta concordou em pagar US$ 1,4 bilhão ao Texas para resolver acusações separadas sobre coleta biométrica.
Esses episódios ajudam a explicar por que o novo caso recebe atenção, mas não provam as alegações atuais. A responsabilidade deve ser analisada com base nas operações do NameTag, do Emu, do Muse Image e nos dados associados ao período indicado na petição. Acordos anteriores também não equivalem necessariamente a admissão de culpa e não substituem a prova exigida no processo recém apresentado.
O que a produção de provas deverá esclarecer
A etapa seguinte tende a concentrar o debate em documentos internos e evidências técnicas. Entre as perguntas mais importantes estão quais conjuntos de dados foram usados para treinar cada modelo, se fotos privadas foram excluídas, como a empresa tratou imagens públicas, se pessoas não cadastradas apareceram no material e quais mecanismos permitiam remover ou contestar o uso de conteúdo.
No caso do NameTag, será necessário determinar se existiu uma base de identificadores pronta para operação, como ela seria formada e de onde viriam os nomes associados aos rostos. Também será relevante saber se a comparação acontecia inteiramente no telefone, se servidores da Meta enviavam apenas software ou também dados faciais, se a companhia podia acessar o conteúdo local e quais regras de retenção haviam sido planejadas.
Para os modelos generativos, especialistas poderão examinar se os vetores criados durante treinamento ou uso são associados a indivíduos identificáveis. A defesa pode sustentar que representações temporárias e parâmetros estatísticos não são equivalentes a modelos biométricos. Os autores tentarão demonstrar que o processamento preserva informações suficientes para reconhecer, reconstruir ou reproduzir pessoas específicas.
Antes disso, a Meta poderá pedir a rejeição total ou parcial da ação. O tribunal também terá de decidir se os autores apresentam alegações plausíveis e se possuem legitimidade para representar grupos tão amplos. A certificação de uma ação coletiva não é automática. Ela depende da existência de questões comuns, da adequação dos representantes e de outros requisitos processuais.
Uma foto do Instagram pode virar dado biométrico?
Do ponto de vista técnico, sim. Uma fotografia pode ser processada por um sistema que mede características faciais e cria uma representação numérica usada para reconhecer alguém. Porém, a simples publicação de uma foto não significa que esse processamento ocorreu, nem que a representação foi armazenada ou usada para identificação. No caso da Meta, essas são justamente as circunstâncias que ainda precisam ser demonstradas.
A controvérsia revela uma mudança importante na relação entre redes sociais e dados pessoais. Fotografias antes tratadas principalmente como conteúdo para compartilhamento também podem servir como insumo para modelos de inteligência artificial. Isso aumenta a importância de políticas claras sobre finalidade, consentimento, retenção, exclusão e uso de imagens de terceiros, especialmente quando uma pessoa aparece em uma foto publicada por outra.
Para usuários, criadores de conteúdo e empresas, a questão central não é apenas se uma imagem está pública. O debate passa a incluir o tipo de processamento realizado sobre ela. Exibir uma foto em um perfil, usá-la para treinar um gerador de imagens e convertê-la em um identificador capaz de reconhecer alguém são operações diferentes. A legalidade de cada uma depende dos fatos, das regras aplicáveis e do consentimento obtido.
Por enquanto, a formulação mais precisa é que a Meta enfrenta acusações de ter usado fotos do Facebook e do Instagram para reconhecimento facial e treinamento de IA sem consentimento adequado. A empresa nega a irregularidade, diz que o NameTag não chegou ao público e rejeita a existência de um banco universal de rostos. Caberá ao processo definir se as imagens dos autores foram efetivamente usadas, se o tratamento produziu dados biométricos protegidos por lei e se as informações fornecidas aos usuários foram suficientes.
O resultado poderá influenciar não apenas a Meta, mas todo o setor de inteligência artificial. Se o tribunal aceitar que certas representações produzidas por modelos generativos constituem dados biométricos, empresas poderão enfrentar obrigações mais rígidas ao treinar sistemas com fotografias de pessoas. Se a tese for rejeitada, a fronteira jurídica entre aprendizado estatístico e identificação biométrica poderá permanecer mais estreita. Em ambos os cenários, a decisão dependerá de provas técnicas que ainda não são públicas.
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,
Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA, Meta é acusada de usar fotos do Facebook e Instagram para reconhecimento facial e treinamento de IA,