Técnica de ataque contra agentes de IA passa a ser usada em spam
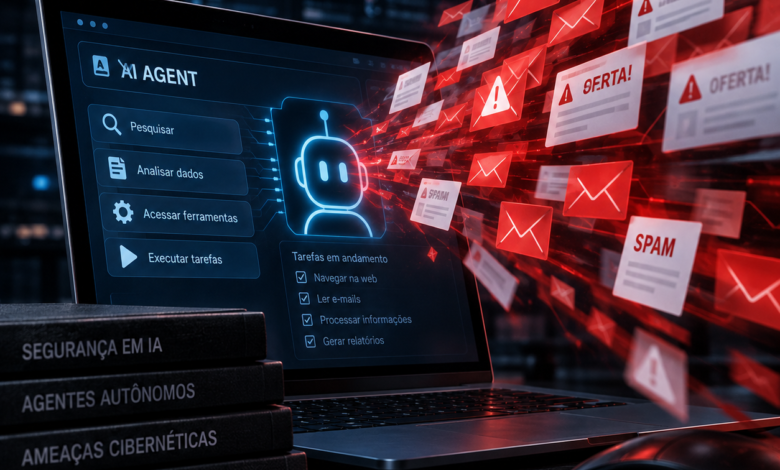
Técnica de ataque contra agentes de IA passa a ser usada em spam – Uma técnica que ganhou projeção em pesquisas sobre segurança de inteligência artificial passou a ser utilizada em campanhas de spam e phishing. Conhecida como ASCII smuggling, ela explora caracteres Unicode que normalmente não aparecem na tela, embora continuem presentes no conteúdo processado por computadores. A diferença entre o que uma pessoa enxerga e o que um sistema interpreta pode ser usada para ocultar instruções, fragmentar palavras e tentar reduzir a eficácia de mecanismos automáticos de detecção.
A migração foi documentada pela Microsoft durante pesquisas relacionadas à proteção contra injeção de prompts no Defender for Office 365. Ao monitorar assinaturas criadas para localizar comandos escondidos em mensagens destinadas a sistemas de IA, os pesquisadores encontraram uma campanha de phishing em grande escala. Nesse caso, os caracteres invisíveis não estavam transmitindo instruções para um modelo. Eles haviam sido colocados no interior de palavras relacionadas a crédito e financiamento, aparentemente com o objetivo de dificultar a análise realizada por filtros de e-mail.
O caso mostra como técnicas discutidas inicialmente em um campo específico da segurança digital podem ser adaptadas rapidamente para fraudes mais convencionais. Também exige cautela. A presença de um caractere invisível não prova, isoladamente, que uma mensagem seja maliciosa. O significado depende do tipo de caractere, de sua posição, do contexto da mensagem e de outros indicadores técnicos.
Técnica de ataque contra agentes de IA passa a ser usada em spam: O que é ASCII smuggling
Apesar do nome, ASCII smuggling não consiste simplesmente no uso do conjunto ASCII tradicional. A expressão descreve, em sua forma mais conhecida, a utilização de uma área especial do padrão Unicode para representar caracteres equivalentes a letras, números, espaços e sinais de pontuação.
O Unicode é o padrão que permite aos sistemas digitais representar textos escritos em diferentes idiomas, além de símbolos, sinais técnicos e emojis. Dentro desse padrão existe um bloco chamado Tags, localizado no intervalo entre U+E0000 e U+E007F. O bloco contém caracteres especiais que correspondem a parte do repertório ASCII, mas que geralmente não produzem uma representação visual em interfaces comuns. O próprio padrão Unicode informa que esses caracteres foram concebidos para permitir marcações internas em fluxos de texto, embora seu uso para indicar idiomas tenha sido descontinuado.
Essa característica cria uma diferença relevante. Uma sequência pode parecer vazia para o leitor e, ao mesmo tempo, continuar armazenada no arquivo, no código HTML, na área de transferência ou no texto entregue a outro programa. Um sistema que analise os caracteres efetivamente presentes pode encontrar informações que não aparecem na tela.
Em pesquisas sobre inteligência artificial, esse recurso passou a ser estudado como uma forma de ocultar instruções dirigidas a modelos de linguagem. Um agente de IA poderia receber o conteúdo bruto de uma página, documento ou e-mail e interpretar uma sequência invisível que o usuário não teve condições de avaliar. Dependendo das permissões atribuídas ao agente e das proteções existentes, isso poderia influenciar respostas, provocar exposição de dados ou induzir operações não autorizadas.
Pesquisas anteriores também demonstraram que outros caracteres invisíveis, incluindo seletores de variação e símbolos matemáticos sem representação própria, podem servir para transportar informações. Isso significa que o problema não se limita a um único intervalo do Unicode. O ponto comum é a possibilidade de inserir dados que sobrevivem ao processamento digital, mas permanecem ausentes ou pouco perceptíveis na interface apresentada ao usuário.
Como a técnica passou dos agentes de IA para o spam
A campanha identificada pela Microsoft alterou a finalidade original do método. Em ataques contra agentes de IA, a intenção costuma ser esconder uma mensagem dos seres humanos e mantê-la disponível para o modelo. No spam observado, os responsáveis queriam que as pessoas continuassem lendo determinadas palavras normalmente, enquanto os filtros encontrariam uma sequência diferente.
Os operadores inseriram um caractere do bloco Tags entre as letras de termos financeiros. Visualmente, uma palavra como “funding”, usada em ofertas de financiamento em inglês, permanecia legível. No conteúdo técnico, porém, havia um caractere U+E0020 entre partes da palavra. Um mecanismo que procurasse apenas a sequência literal completa poderia interpretar o termo como dois fragmentos separados.
Há uma precisão importante nessa classificação. Segundo a análise da Microsoft, as mensagens examinadas não continham frases inteiras codificadas por meio do bloco Tags. Os remetentes utilizavam um único tipo de caractere invisível como separador. Tecnicamente, portanto, o comportamento se aproxima mais de uma inserção de caracteres invisíveis pertencentes ao mesmo bloco associado ao ASCII smuggling do que do transporte completo de uma mensagem escondida.
A distinção não reduz a relevância do episódio. Ela ajuda a descrever corretamente o que aconteceu e evita atribuir à campanha capacidades que não foram demonstradas. O método observado tinha como finalidade aparente fragmentar palavras consideradas relevantes pelos sistemas de segurança, não comandar um agente de inteligência artificial.
Campanha alcançou milhões de mensagens por dia
Os primeiros sinais do aumento apareceram na telemetria da Microsoft em 9 de fevereiro de 2026. A atividade permaneceu elevada durante aproximadamente três meses, com forte concentração nos dias úteis e quedas acentuadas nos fins de semana. No período de maior intensidade, o volume ficou entre 1 milhão e 2,37 milhões de mensagens por dia útil. O pico foi registrado em 26 de fevereiro.
A utilização da técnica começou a cair gradualmente e recuou de maneira mais acentuada depois de 15 de maio. Ainda houve atividade residual até meados de junho. Esses números representam mensagens que acionaram a assinatura específica usada na pesquisa, e não necessariamente toda a operação de phishing relacionada ao grupo. A campanha mais ampla já existia antes da adoção dos caracteres Unicode e continuou depois que esse método deixou de aparecer com a mesma frequência.
Cerca de 96% do volume associado à assinatura foi relacionado a domínios com nomes de temática financeira. Os endereços combinavam palavras referentes a capital, crédito, empréstimos, crescimento e financiamento. As mensagens procuravam se apresentar como ofertas comerciais dirigidas principalmente a empresas interessadas em linhas de crédito ou antecipação de recursos.
A Microsoft relacionou essa atividade a uma campanha mais ampla que utilizava infraestrutura da ActiveCampaign, plataforma legítima de automação e marketing por e-mail. O uso de um serviço reconhecido pode dificultar análises baseadas exclusivamente na reputação da infraestrutura, já que os links e servidores empregados também atendem clientes legítimos.
Isso não significa que a plataforma estivesse envolvida na fraude. Serviços de marketing, hospedagem e armazenamento frequentemente enfrentam tentativas de abuso por clientes ou contas comprometidas. A ActiveCampaign informou que mensagens com caracteres invisíveis recebiam em seus sistemas o mesmo resultado de moderação que as versões sem ofuscação e que o uso intenso desses elementos também era tratado como sinal suspeito.
Por que caracteres invisíveis podem confundir filtros de e-mail
Os filtros modernos não dependem de uma única tecnologia. Eles analisam a reputação do remetente, o endereço IP de origem, a autenticação do domínio, os links incluídos na mensagem, o volume de envios, a estrutura do conteúdo e padrões associados à engenharia social. Sistemas mais avançados também empregam aprendizado de máquina, processamento de linguagem natural e análise visual.
Ainda assim, diferentes componentes podem interpretar o mesmo texto de maneiras distintas. Um filtro baseado em correspondência literal procura uma sequência exata de caracteres. Quando um símbolo invisível aparece no meio de uma palavra, a sequência deixa de ser contínua, ainda que o resultado exibido para o usuário pareça inalterado.
Expressões regulares também podem ser afetadas quando não foram preparadas para considerar caracteres intercalados. O mesmo problema pode chegar à etapa de tokenização, na qual um sistema divide frases em palavras ou partes menores antes da classificação. Uma palavra conhecida pelo modelo pode se transformar em dois fragmentos acompanhados de um caractere raro. Isso altera a representação matemática fornecida ao classificador e pode reduzir o peso de um termo associado a spam ou phishing.
O resultado depende da ordem das etapas. Se o sistema remover ou normalizar os caracteres invisíveis antes da análise, a palavra original volta a ser identificada. Caso a tokenização ocorra antes dessa limpeza, o conteúdo pode ser dividido de forma inesperada. Implementações diferentes, portanto, podem apresentar respostas distintas diante da mesma mensagem.
Uma alternativa utilizada por algumas soluções consiste em produzir uma imagem da mensagem e extrair o texto visível por reconhecimento óptico de caracteres. Como essa análise parte do resultado exibido, ela tende a recuperar a palavra da maneira como o destinatário a enxerga. Porém, o reconhecimento visual também possui limitações e deve integrar uma arquitetura com várias camadas de proteção.
A técnica não tornou os e-mails indetectáveis
A documentação disponível não permite afirmar que o ASCII smuggling tenha atravessado de forma generalizada as proteções das plataformas de e-mail. O que está comprovado é o uso do método em uma tentativa de evasão e sua presença em volumes elevados.
No ambiente analisado pela Microsoft, mais de 99% das mensagens foram classificadas por mecanismos que não dependiam diretamente da identificação dos caracteres do bloco Tags. Entre esses mecanismos estavam reputação de remetentes, domínios, endereços IP e URLs, além de verificações de autenticação, modelos de classificação e controles contra falsificação de marcas.
Esse dado é essencial para evitar uma interpretação alarmista. A técnica pode afetar componentes específicos, especialmente filtros simples que procuram palavras exatas. No entanto, um sistema bem configurado não deveria depender exclusivamente do texto visível ou de uma lista de termos proibidos.
O próprio uso de caracteres tão raros pode favorecer os defensores. Depois que uma prática é reconhecida e incorporada às regras de monitoramento, aquilo que pretendia esconder uma palavra passa a funcionar como anomalia. Uma mensagem financeira comum dificilmente precisa colocar um caractere do bloco Tags dentro de termos como crédito ou financiamento.
A disputa entre evasão e detecção também é dinâmica. Assim que filtros passam a identificar uma sequência, os responsáveis pelas campanhas podem trocar caracteres, alterar o conteúdo ou abandonar o método. Por isso, a segurança não pode ser baseada somente em uma assinatura fixa. É necessário relacionar o texto a padrões de envio, infraestrutura, links, autenticação, comportamento da conta e finalidade aparente da mensagem.
ASCII smuggling não é a primeira forma de ocultação em spam
A inserção de símbolos invisíveis ou visualmente semelhantes é anterior à atual expansão da inteligência artificial. Campanhas de spam já utilizavam espaços de largura zero, espaços inseparáveis, hífens opcionais e caracteres de alfabetos diferentes que se parecem com letras latinas.
Essas técnicas procuram explorar a diferença entre aparência e estrutura. Uma palavra pode continuar compreensível para uma pessoa mesmo quando algumas letras foram substituídas ou separadas. Para um filtro que compara sequências exatas, entretanto, cada alteração pode gerar uma combinação nova.
A novidade está no uso em grande escala de caracteres do bloco Tags, que haviam ganhado visibilidade recente nas discussões sobre injeção de prompts. A campanha sugere que operadores de spam acompanham pesquisas publicadas em outros segmentos da segurança e incorporam métodos que possam ser reutilizados com pouco custo.
Também existe uma possível relação com a disseminação de ferramentas de teste. Quando pesquisadores documentam um comportamento, desenvolvem detectores e demonstram como ele funciona, a informação beneficia equipes defensivas, mas também pode ser observada por agentes maliciosos. Esse problema acompanha a divulgação de vulnerabilidades e técnicas de ataque há décadas. A diferença atual está na velocidade de adaptação entre sistemas de IA, plataformas de mensagens e operações de fraude digital.
Nem todo caractere Unicode invisível é malicioso
A identificação de caracteres não visíveis deve ser tratada como parte de uma análise contextual. O Unicode inclui controles que influenciam a direção do texto, a combinação entre símbolos, a seleção de variantes e a exibição de idiomas com regras específicas. Alguns deles são necessários para a representação correta de determinados sistemas de escrita.
O próprio bloco Tags possui usos legítimos em sequências associadas a bandeiras regionais. A Microsoft relatou que uma versão inicial de sua assinatura também identificava mensagens contendo os emojis das bandeiras da Inglaterra, Escócia e País de Gales. Depois dessa constatação, os pesquisadores ajustaram a regra para excluir essas sequências.
Uma política que simplesmente rejeite qualquer mensagem com caracteres invisíveis pode gerar falsos positivos, afetar comunicações legítimas e criar problemas para idiomas ou recursos específicos. A defesa mais adequada considera a quantidade de caracteres, sua posição, o tipo de sequência e sua relação com outros elementos suspeitos.
Um símbolo inserido no meio de várias palavras financeiras, enviado por um domínio recém registrado e acompanhado por links de rastreamento incomuns representa um cenário diferente daquele encontrado em uma mensagem que contém um emoji legítimo. A presença do caractere funciona melhor como um indicador a ser correlacionado do que como prova definitiva de fraude.
Como empresas podem reduzir o risco
A principal recomendação técnica é normalizar o conteúdo antes que ele seja submetido a verificações de palavras, assinaturas ou expressões regulares. Nesse processo, caracteres invisíveis sem função necessária podem ser removidos ou convertidos para uma representação consistente. O filtro passa então a analisar uma versão mais próxima daquilo que o usuário efetivamente vê.
A mesma normalização precisa ser aplicada ao assunto, ao corpo da mensagem e, quando pertinente, ao texto extraído de conteúdo HTML. Também é recomendável comparar a versão original com a versão normalizada. Uma diferença incomum pode elevar a classificação de risco, principalmente quando os caracteres aparecem dentro de palavras relacionadas a dinheiro, credenciais, pagamentos ou urgência.
Soluções corporativas devem testar como seus próprios mecanismos lidam com o intervalo U+E0000 a U+E007F. Não basta presumir que bibliotecas de texto, tokenizadores, gateways de segurança e modelos de aprendizado de máquina realizem a mesma normalização. Cada etapa pode preservar, remover ou reinterpretar os caracteres.
A análise deve continuar incluindo autenticação de e-mail, reputação de domínios, comportamento do remetente, destino dos links e volume de distribuição. Treinamentos de usuários também permanecem relevantes, porque a mensagem exibida pode parecer perfeitamente normal. Ofertas financeiras inesperadas, solicitações de credenciais e links que levam a páginas desconhecidas devem ser avaliados mesmo quando não há erros visíveis no texto.
Segurança de IA e combate ao phishing estão cada vez mais próximos
O episódio reforça a aproximação entre a segurança de agentes de IA e a proteção tradicional do correio eletrônico. E-mails já são uma fonte frequente de conteúdo para assistentes digitais, sistemas de resumo, ferramentas de produtividade e agentes autorizados a consultar calendários, documentos ou aplicações empresariais.
Uma mensagem pode tentar enganar simultaneamente o filtro, o destinatário e o agente que processa sua caixa de entrada. Por essa razão, a normalização de caracteres invisíveis não serve apenas para recuperar palavras fragmentadas. Ela também pode impedir que instruções ocultas sejam entregues diretamente a um modelo de linguagem.
A mudança observada não representa o aparecimento de um mecanismo totalmente novo de fraude. Ela revela a adaptação de uma antiga lógica de ofuscação a caracteres que receberam atenção recente por causa da inteligência artificial. O risco real está na divergência entre texto exibido, texto armazenado e texto interpretado por cada componente.
O ASCII smuggling passa, assim, a ocupar duas áreas de interesse para as equipes de segurança. De um lado, permanece como técnica capaz de ocultar conteúdo dirigido a modelos e agentes. De outro, surge como instrumento para fragmentar termos e tentar escapar de filtros de spam e phishing. A resposta mais eficaz depende de análise em camadas, normalização cuidadosa e correlação entre sinais, sem transformar todo caractere Unicode invisível em sinônimo automático de atividade criminosa.
Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam
Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam
Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam
Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam, Técnica de ataque contra agentes de IA passa a ser usada em spam
Segurança de IA e combate, Segurança de IA e combate ao phishing, caractere Unicode invisível é malicioso, ASCII smuggling, Por que caracteres invisíveis podem confundir filtros de e-mail, Como a técnica passou dos agentes de IA para o spam, O que é ASCII smuggling, ASCII smuggling migra de ataques contra agentes de IA para campanhas de spam, Técnica de ataque contra agentes de IA passa a ser usada em spam
2 Comentários